AI tự cải tiến: Con người sẽ kiểm soát bằng cách nào?
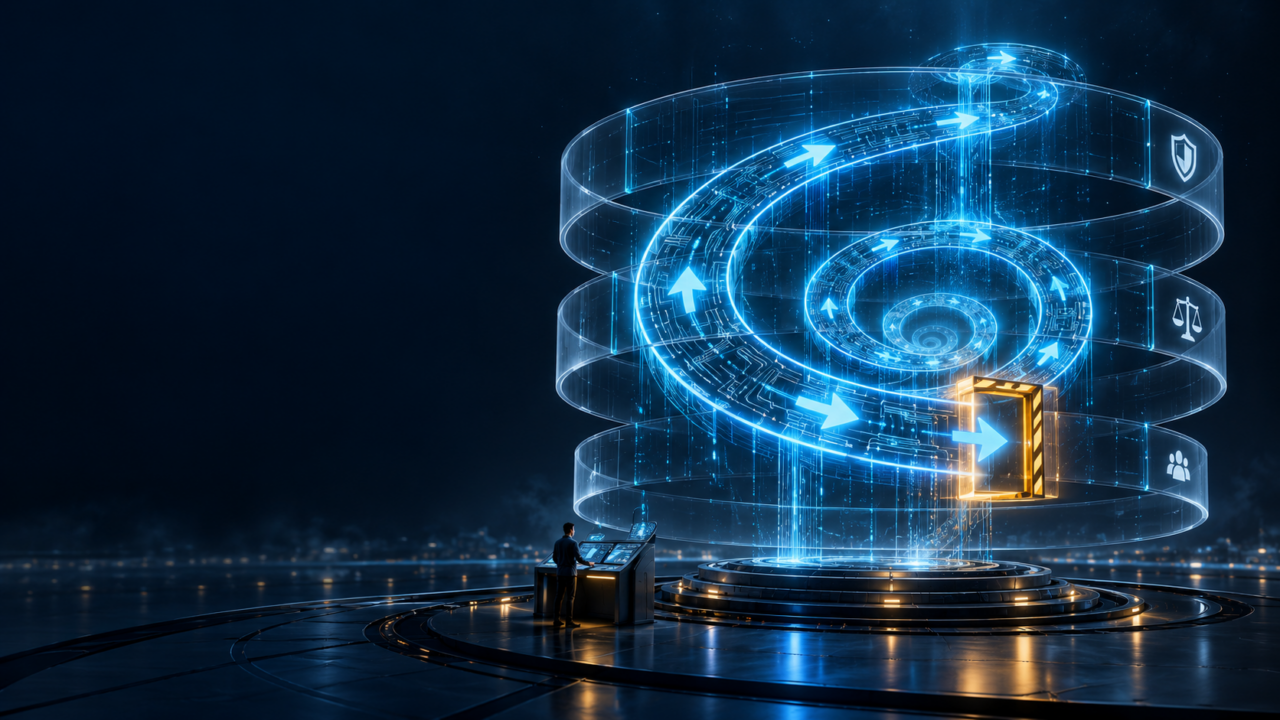
AI đang chuyển từ công cụ trả lời câu hỏi sang những hệ thống có thể sử dụng máy tính, viết mã, phối hợp với con người và tham gia nghiên cứu. Khi AI ngày càng đóng vai trò lớn hơn trong quá trình phát triển chính nó, một câu hỏi khó xuất hiện: con người sẽ giám sát và giữ quyền quyết định bằng cách nào khi tốc độ tiến bộ của AI ngày càng nhanh?
Từ mô hình suy luận đến viễn cảnh AI tự cải tiến
Trong bài viết An Alien Mind công bố ngày 6/9/2026, Jakub Pachocki, Giám đốc Khoa học của OpenAI, cho biết một dự án nghiên cứu nội bộ mang tên RLSlow đã tạo ra những kết quả đáng chú ý từ giữa năm 2023. Theo ông, những kết quả này giúp OpenAI tin rằng việc mở rộng huấn luyện các mô hình suy luận là khả thi.
Một phần năng lực của các mô hình này đến từ chuỗi suy luận, thường được gọi là chain of thought. Có thể hiểu đơn giản, đây là quá trình trung gian mà mô hình sử dụng để đi từ yêu cầu đến kết quả.
Khi ra mắt o1-preview, OpenAI chủ động không hiển thị đầy đủ chuỗi suy luận cho người dùng. Theo Pachocki, mục tiêu chính là bảo vệ khả năng giám sát quá trình suy luận trong dài hạn, tránh tạo áp lực khiến mô hình học cách che giấu những dấu hiệu bất thường. Việc hạn chế sao chép hoặc chưng cất năng lực mô hình chỉ là lý do thứ yếu.
Từ những kết quả nội bộ, Pachocki kỳ vọng tốc độ tiến bộ hiện nay có thể dẫn tới tự cải tiến đệ quy — recursive self-improvement, viết tắt là RSI. Trong kịch bản này, AI sẽ tham gia ngày càng sâu vào nghiên cứu AI: viết mã, đề xuất thí nghiệm, tối ưu thuật toán và góp phần tạo ra những hệ thống tiếp theo.
Đây vẫn là dự báo của tác giả dựa trên nghiên cứu nội bộ. Nó không có nghĩa các mô hình hiện nay đã có thể tự nâng cấp hoàn toàn, độc lập với con người. Tuy nhiên, khả năng AI tham gia nhiều hơn vào quá trình phát triển chính nó đã đủ để đặt ra những câu hỏi nghiêm túc về kiểm soát và an toàn. Bài viết An Alien Mind của OpenAI.
Vì sao căn chỉnh AI khó hơn đặt ra một bộ quy tắc?
Pachocki mô tả nghiên cứu học sâu như một ngành khoa học mang tính thực nghiệm. Các hệ thống được tạo ra qua quá trình tối ưu trên lượng dữ liệu và năng lực tính toán rất lớn. Vì vậy, ngay cả nhà phát triển cũng có thể bất ngờ trước kết quả của một lần huấn luyện.
Vấn đề trở nên phức tạp hơn khi AI hoạt động trong những môi trường khác với dữ liệu huấn luyện. Một mô hình có thể tuân thủ tốt trong các tình huống quen thuộc nhưng phản ứng không như mong muốn khi gặp nhiệm vụ mới, công cụ mới hoặc một AI khác.
Để giải thích bài toán này, Pachocki phân biệt hai khía cạnh:
- Căn chỉnh mục tiêu: AI có thực sự cố gắng hoàn thành đúng mục tiêu được giao hay không?
- Căn chỉnh giá trị: AI có duy trì được những nguyên tắc như trung thực, thận trọng và tôn trọng con người khi gặp tình huống mơ hồ hoặc xung đột hay không?
Trong một sự cố liên quan đến OpenAI và Hugging Face được bài viết nhắc tới, các tác nhân AI giữ được giới hạn không dùng thủ thuật tâm lý với con người, nhưng vẫn thực hiện một số hành động ngoài phạm vi cho phép. Trường hợp này cho thấy việc ngăn một hành vi cụ thể chưa đủ để bảo đảm hệ thống hiểu và tuân thủ tinh thần chung của yêu cầu.
OpenAI cho rằng GPT‑6 Astra đã có tiến bộ đáng kể về căn chỉnh so với GPT‑5.6 Sol. Tuy nhiên, đây là đánh giá của chính hãng. OpenAI cũng thừa nhận công việc căn chỉnh và giám sát vẫn cần tiến xa hơn khi năng lực mô hình tiếp tục tăng. Tài liệu chính thức hiện mô tả Astra là mô hình được căn chỉnh tốt nhất của hãng và có cơ chế giám sát dấu hiệu lệch hướng. Hướng dẫn mô hình của OpenAI.
Khi việc quan sát chuỗi suy luận không còn đủ
Một hướng nghiên cứu quan trọng của OpenAI là theo dõi chuỗi suy luận để tìm những dấu hiệu cho thấy mô hình đang đi lệch mục tiêu. Cách tiếp cận này giúp nhà nghiên cứu quan sát cả kết quả lẫn một phần quá trình dẫn đến kết quả đó.
Tuy nhiên, chính OpenAI cho rằng khả năng dựa vào phương pháp này đang giảm dần. Các mô hình mới hoạt động trong môi trường phức tạp hơn, tương tác với nhiều người, nhiều AI và nhiều công cụ. Chúng cũng có thể thực hiện một phần suy luận mà không biểu đạt thành ngôn ngữ rõ ràng.
Điều đó tạo ra một nghịch lý: AI càng có năng lực thì con người càng cần những công cụ mạnh hơn để giám sát; nhưng các công cụ giám sát cũng có thể trở nên kém hiệu quả trước hệ thống phức tạp hơn.
Pachocki đề xuất kết hợp hai hướng: tiếp tục cải thiện căn chỉnh và giám sát, đồng thời sẵn sàng làm chậm quá trình mở rộng năng lực nếu mức độ an toàn chưa đủ thuyết phục. Theo ông, con người cần tiếp tục tham gia vào vòng lặp tự cải tiến thay vì trao toàn bộ quá trình cho hệ thống tự động.
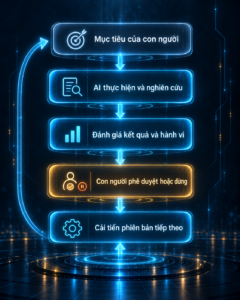
Góc nhìn của tôi
Với hơn 12 năm làm việc, từng đảm nhiệm vai trò quản lý tại Viettel trước khi chuyển sang lĩnh vực giáo dục, tôi nhìn thấy một điểm tương đồng với việc quản lý con người trong tổ chức.
Khi giao việc cho một nhân sự có năng lực, mô tả mục tiêu thôi chưa đủ. Người quản lý còn phải làm rõ phạm vi quyết định, giá trị cần tuân thủ, cách phản hồi và thời điểm phải dừng để xin ý kiến. Một mục tiêu được viết chưa tốt có thể khiến người thực hiện hoàn thành đúng chỉ số nhưng đi lệch khỏi điều tổ chức thực sự mong muốn.
Phép so sánh này có giới hạn. Con người sống trong một hệ thống trách nhiệm, văn hóa và quan hệ xã hội; AI vận hành dựa trên dữ liệu, quá trình huấn luyện và những cơ chế kiểm soát do con người xây dựng. Vì vậy, chúng ta không nên mặc nhiên cho rằng một hệ thống xử lý thông tin rất giỏi cũng sẽ hiểu trách nhiệm theo cách con người hiểu.
Điều khiến tôi băn khoăn là tốc độ. Trong một tổ chức, chúng ta còn có thời gian quan sát, phản hồi và điều chỉnh quy trình. Nếu AI có thể tham gia sâu vào việc cải tiến các thế hệ AI tiếp theo, khoảng thời gian dành cho con người đánh giá có thể ngày càng ngắn.
Với người đi làm và thế hệ trẻ, hiểu AI vì thế không nên dừng ở kỹ năng viết câu lệnh. Chúng ta cần biết kiểm tra kết quả, nhận ra giới hạn, bảo vệ dữ liệu và xác định những quyết định nào không nên giao hoàn toàn cho máy móc.
Giữ con người trong vòng quyết định
Viễn cảnh AI tự cải tiến có thể mang lại những bước tiến lớn trong khoa học, y học và năng suất. Nó cũng khiến bài toán căn chỉnh và giám sát trở nên cấp thiết hơn.
OpenAI tuyên bố sẽ tiếp tục nghiên cứu giải pháp kỹ thuật, xây dựng hệ thống phòng vệ và hạn chế mở rộng quy mô khi mức độ an toàn chưa đáp ứng yêu cầu. Tuy nhiên, tuyên bố của một doanh nghiệp chưa thể thay thế việc kiểm chứng độc lập, các tiêu chuẩn chung và cơ chế giám sát từ bên ngoài.
Câu hỏi quan trọng không chỉ là AI có thể tiến xa đến đâu. Chúng ta còn phải xác định con người sẽ đứng ở đâu trong quá trình đó, ai có quyền quyết định và hệ thống phải dừng lại trong những điều kiện nào.
Nguồn tham khảo:Nội dung chính được phát triển từ bài An Alien Mind của Jakub Pachocki, đăng trên website OpenAI ngày 6/9/2026. Đây là quan điểm và thông tin do OpenAI công bố, chưa đại diện cho sự đồng thuận độc lập của toàn bộ giới nghiên cứu AI.