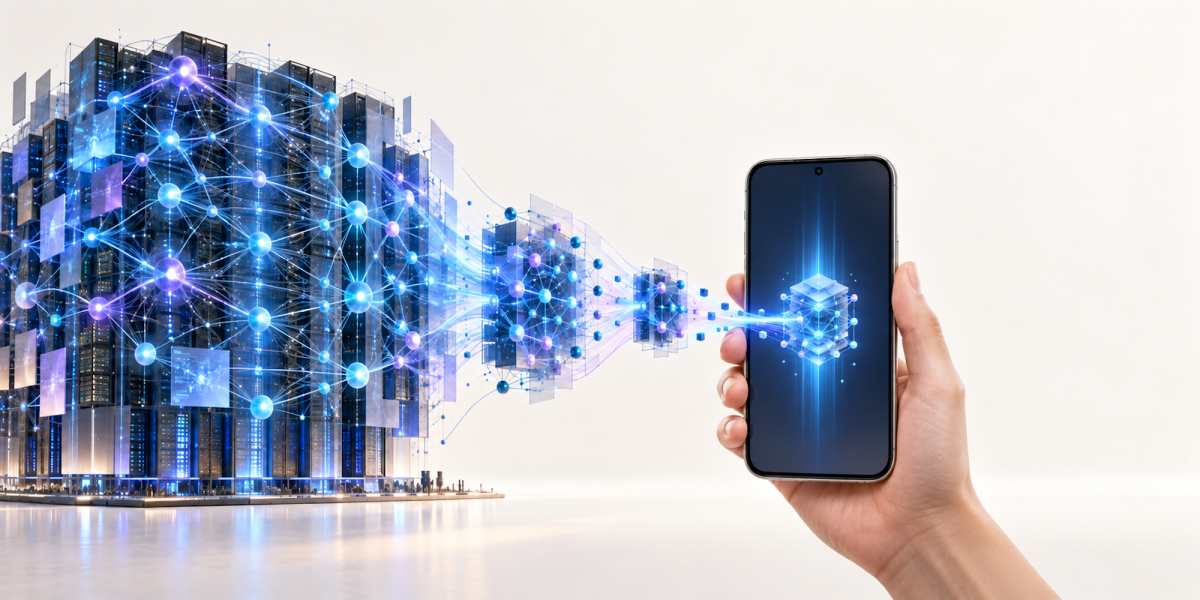
Hầu hết chúng ta đều đã quen với việc gửi yêu cầu đến các mô hình trí tuệ nhân tạo (AI) chạy trên đám mây và chờ đợi phản hồi. Tuy nhiên, mô hình vận hành này đang vấp phải những rào cản lớn về chi phí vận hành, tốc độ đường truyền và tính bảo mật dữ liệu cá nhân. Giải pháp lý tưởng là đưa AI về chạy trực tiếp trên thiết bị cá nhân (on-device AI). Thế nhưng, làm thế nào để nhồi nhét một mô hình khổng lồ với hàng chục tỷ tham số vào bộ nhớ hữu hạn của một chiếc điện thoại hay máy tính cá nhân?
Vào ngày 17/09/2026, startup AI PrismML đã đưa ra câu trả lời đầy ấn tượng bằng việc phát hành Bonsai 2 27B, một mô hình được nén từ Qwen3.8 27B của Alibaba xuống chỉ còn 5.9 GB, mở ra triển vọng đưa trí tuệ nhân tạo cao cấp đến tay mọi người dùng một cách miễn phí và riêng tư.
Bonsai 2 27B: Từ mô hình khổng lồ đến kích thước bỏ túi
Để giải quyết bài toán chạy AI trực tiếp trên thiết bị, PrismML đã chọn mô hình mã nguồn mở Qwen3.8 27B của Alibaba làm nền tảng. Qwen3.8 27B là một LLM (Large Language Model – Mô hình ngôn ngữ lớn, hệ thống AI được huấn luyện trên lượng văn bản khổng lồ để hiểu và tạo ra ngôn ngữ giống con người) mạnh mẽ với 27 tỷ tham số. Tuy nhiên, kích thước nguyên bản của nó đòi hỏi tài nguyên phần cứng vượt quá khả năng của hầu hết các thiết bị cá nhân thông thường.
Bằng công nghệ nén độc quyền, PrismML đã giảm dung lượng bộ nhớ yêu cầu của mô hình này từ 9 đến 10 lần, đưa kích thước của Bonsai 2 27B xuống vỏn vẹn 5.9 GB. Đây là một bước tiến vượt bậc so với phiên bản Bonsai đầu tiên được phát hành vào tháng 3/2026. Ở phiên bản đầu, mô hình nén của họ đạt hiệu suất tương đương 95% so với bản gốc và đã gặt hái được thành công lớn với hơn 11 triệu lần tải xuống. Các mô hình nhỏ hơn khác của startup này cũng tích lũy được 2.6 triệu lần tải. Với Bonsai 2 27B, hiệu suất đã được đẩy lên tới 98% so với bản gốc, biến nó thành một trong những mô hình nén hiệu quả nhất trên thị trường hiện nay.
Bí quyết công nghệ: Sức mạnh của trọng số tam phân
Thông tin do PrismML tự công bố cho thấy, chìa khóa giúp họ đạt được tỷ lệ nén kinh ngạc này nằm ở phương pháp trọng số tam phân (ternary weights). Trong các mô hình AI truyền thống, các “weights” (Trọng số – các tham số bằng số mà mô hình AI học và lưu trữ trong quá trình huấn luyện để đưa ra quyết định hoặc dự đoán) thường được biểu diễn dưới dạng số thực độ chính xác cao 16 bit. Việc lưu trữ hàng tỷ số thực này ngốn một lượng lớn bộ nhớ và băng thông xử lý của chip.
Kỹ thuật trọng số tam phân của PrismML giải quyết vấn đề này bằng cách đơn giản hóa giá trị của mỗi trọng số xuống chỉ còn một trong ba giá trị duy nhất: +1, -1, hoặc 0. Việc giảm số lượng trạng thái từ hàng vạn giá trị số thực xuống còn ba trạng thái cơ bản giúp giảm đáng kể lượng bit cần thiết để lưu trữ mỗi trọng số.
Dù việc lược bỏ thông tin này thường dẫn đến suy giảm nghiêm trọng khả năng suy luận của AI, PrismML tuyên bố thuật toán tối ưu hóa của họ cho phép giữ lại hầu như nguyên vẹn năng lực của mô hình gốc. Hệ thống hầu như không bị suy giảm hiệu suất và vẫn duy trì được độ thông minh đáng kinh ngạc dù kích thước t